유사도와 거리
벡터 DB에서의 유사도와 거리
데이터베이스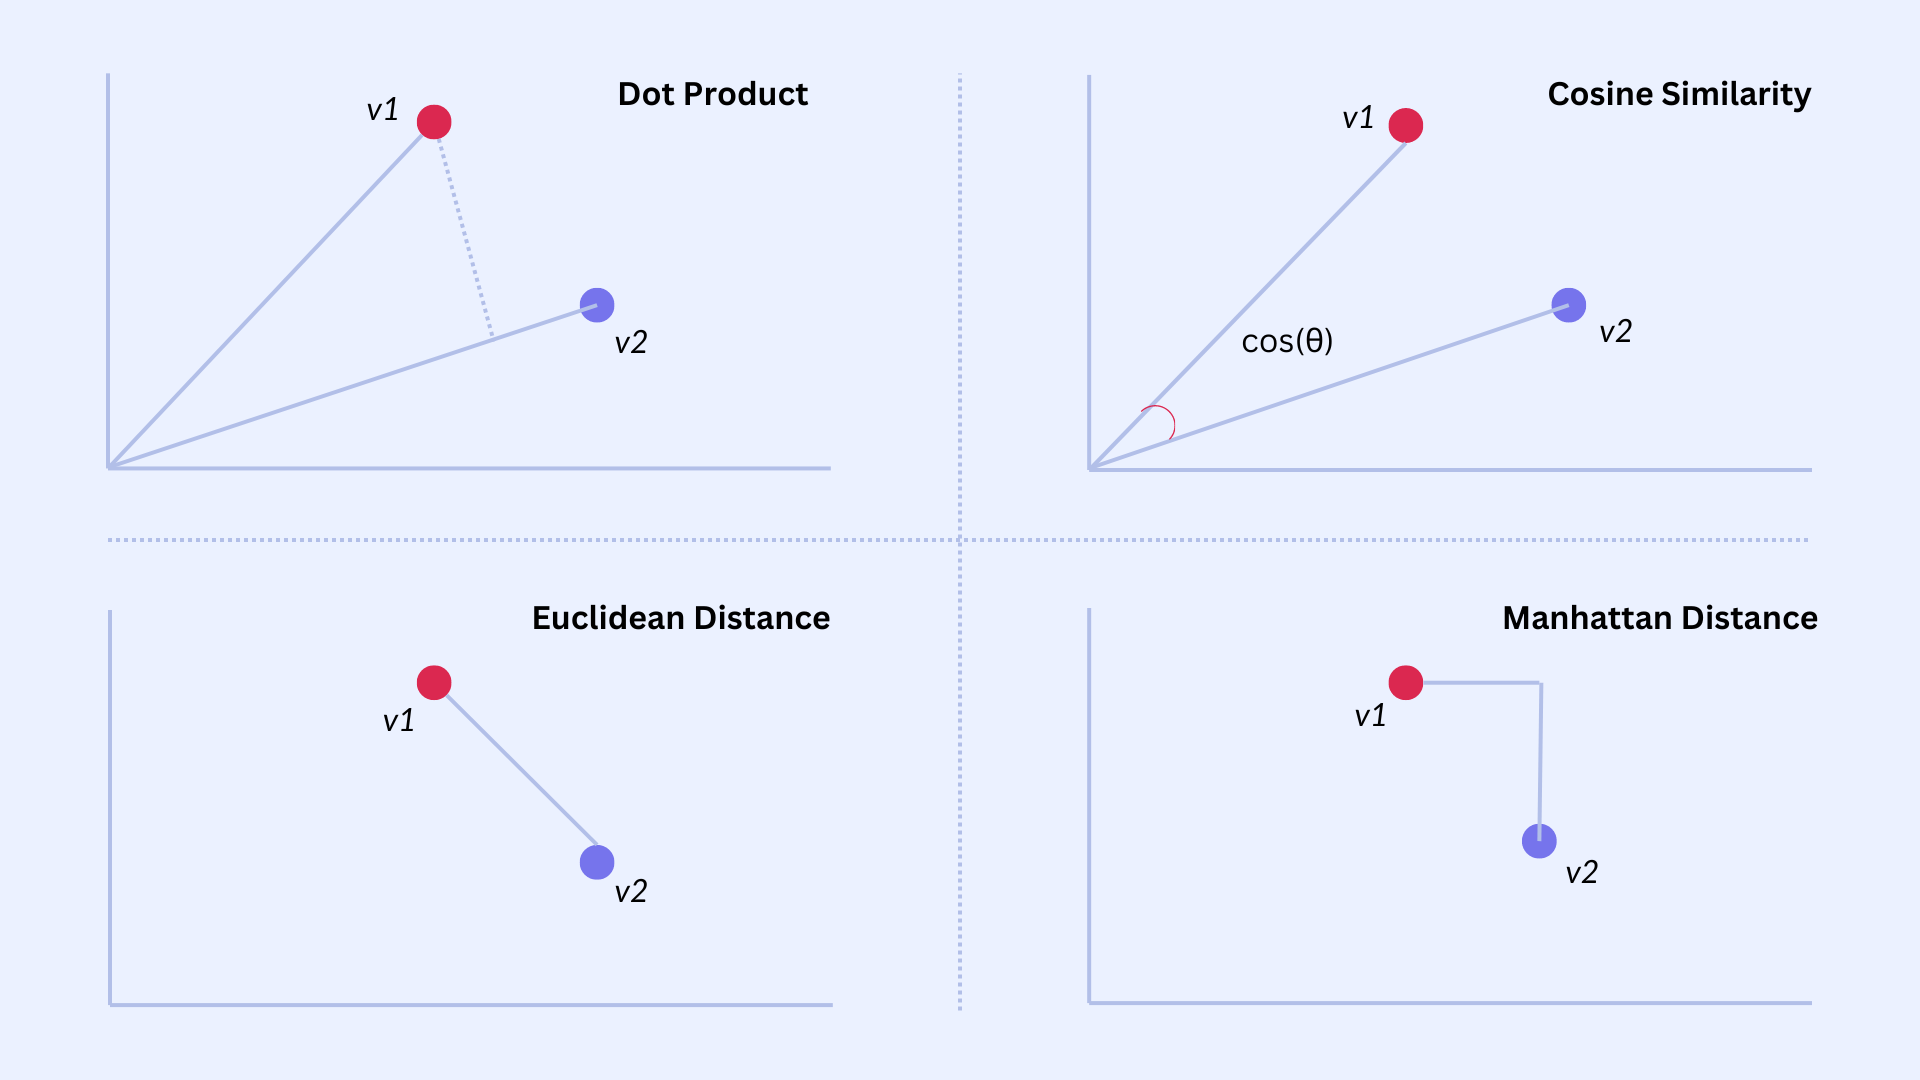
벡터 DB가 "가장 유사한 벡터를 찾는다"고 할 때, 그 '유사함'의 기준을 정하는 것
벡터 공간에서 두 벡터가 얼마나 가깝고, 얼마나 비슷한지를 수치적으로 측정하기 위해서는 아래 두 가지 방법을 사용할 수 있다. 이 계산 결과를 바탕으로 어떤 데이터가 더 유사한지 순위를 매기는 것이다.
1. 유클리드 거리: 두 점 사이의 직선 거리
벡터가 가리키는 두 개의 점을 가장 짧은 직선으로 이었을 때의 거리를 계산한다.
- 개념: 두 벡터 간의 물리적인 거리
- 계산 결과: 값이 작을수록 두 벡터는 가깝고, 더 유사하다고 판단
- 거리가 0이면 두 벡터는 완전히 동일
- 비유: 지도 위의 두 지점을 자로 잰 직선거리와 같음
2. 코사인 유사도: 두 벡터 사이의 방향성
유클리드 거리가 두 점의 위치 차이에 집중한다면, 코사인 유사도는 두 벡터가 얼마나 같은 방향을 바라보고 있는지에 집중한다. 두 벡터 사이의 각도(θ)에 대한 코사인 값을 이용한다.
- 개념: 두 벡터 간의 방향의 일치성
- 계산 결과: -1 < 값 < 1
- -1: 두 벡터가 서로 정 반대 방향 (가장 유사하지 않음)
- 0: 두 벡터가 서로 90도 직각 (관련성 없음)
- 1: 두 벡터가 완전히 같은 방향을 가리킴 (가장 유사)
- 비유: 원점에서 두 지점을 바라봤을 때, 두 시선이 이루는 각도가 얼마나 좁은지를 보는 것
코사인 유사도는 다음 수식을 기반으로 계산한다.
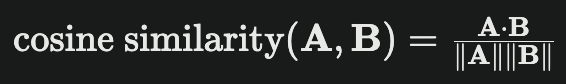
두 벡터 A와 B가 있을 때 A와 B의 내적(같은 위치에 있는 요소들을 곱한 후 모두 더한 값)을 A의 크기와 B의 크기를 곱한 값으로 나눈다.
사용 적합도 평가
| 구분 | 유클리드 거리 | 코사인 유사도 |
|---|---|---|
| 핵심 | 크기와 거리 | 방향성 |
| 특징 | 값의 범위에 제한이 없음, 값이 작을수록 유사 | -1 ~ 1 사이의 값, 1에 가까울수록 유사 |
| 주요 사용처 | 이미지 분석 등 벡터의 크기 자체가 의미 있는 정보일 때 | 문서나 텍스트 분석 등 내용의 방향성(주제)이 중요할 때 |
특히 텍스트를 벡터화한 경우, 문장의 길이에 따라 벡터의 크기가 달라질 수 있다.
예를 들어, "맛집" 이라는 짧은 문서와 "이 동네에서 가장 유명한 맛집은 어딘가요?"라는 긴 문서는 내용은 비슷하지만 벡터의 크기는 다를 수 있다.
이럴 때 유클리드 거리를 사용하면 단순히 길다는 이유로 거리가 멀다고 판단할 수 있지만, 코사인 유사도는 크기와 상관 없이 두 문장이 '맛집'이라는 동일한 주제(방향)를 가리키므로 높게 측정된다.