벡터 임베딩
벡터 임베딩이란...
데이터베이스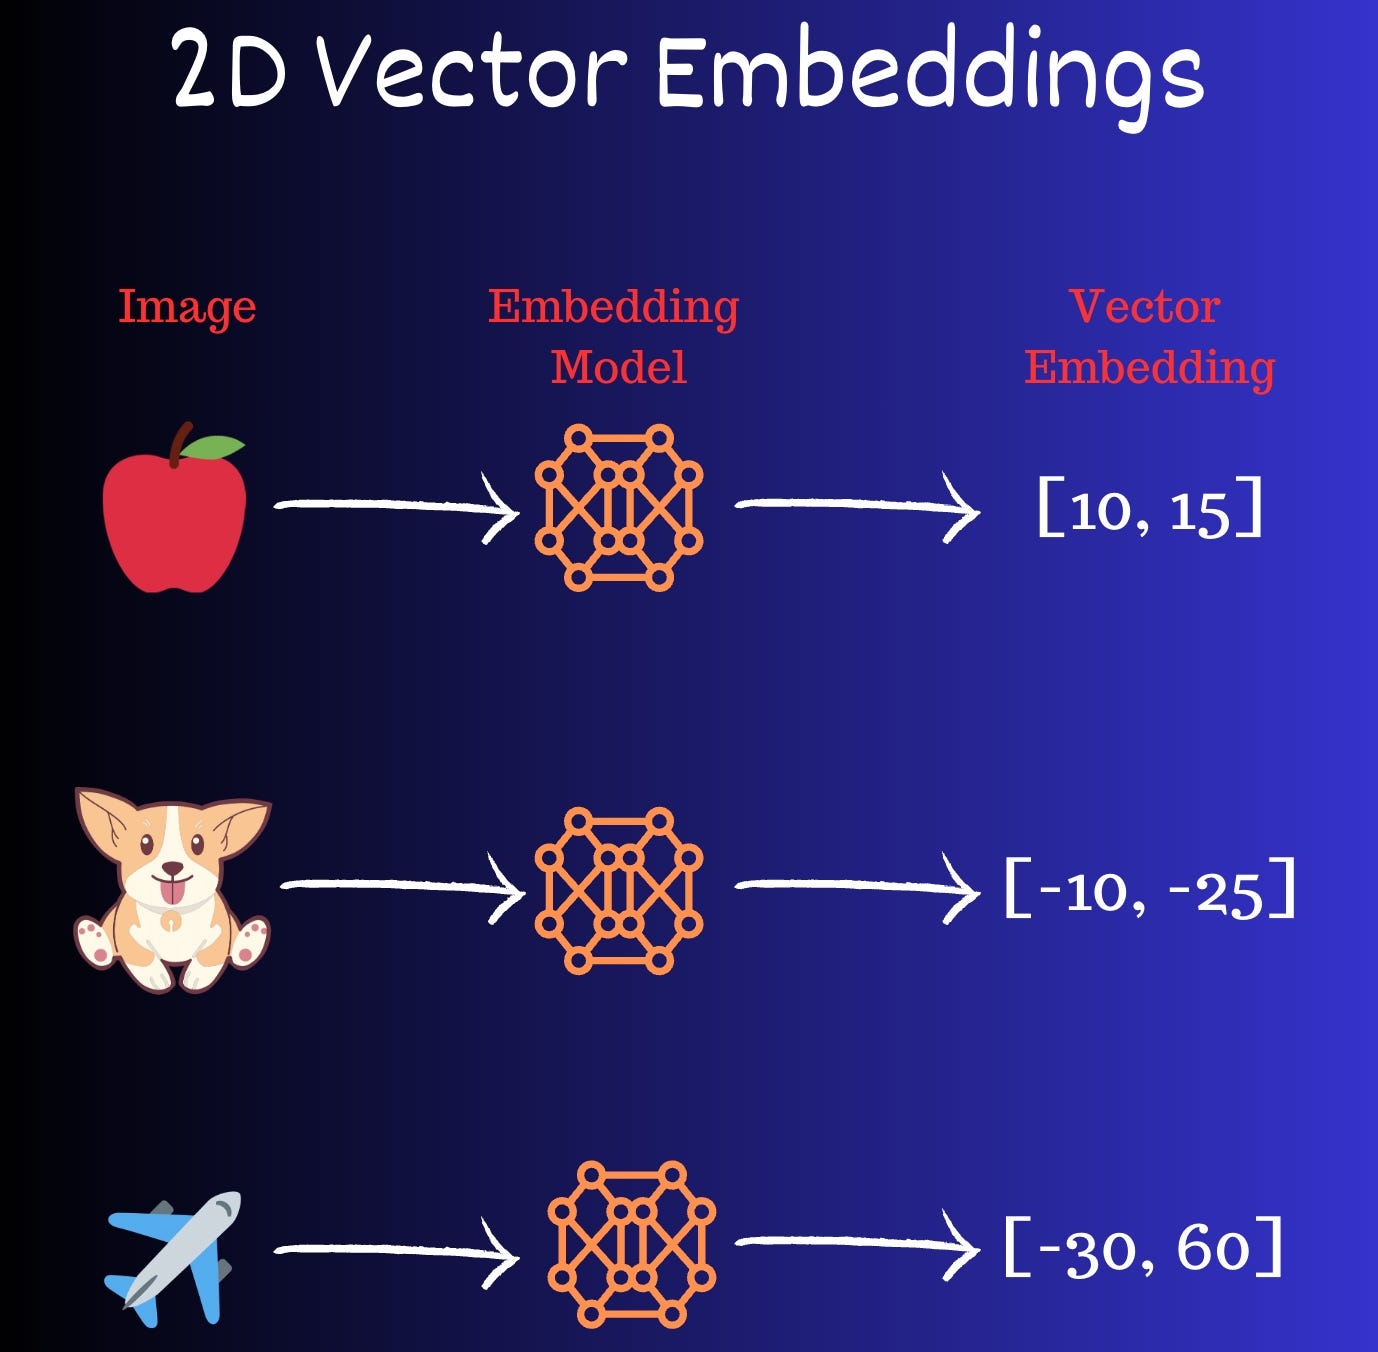
정의
'의미'를 숫자로 번역하는 기술
컴퓨터는 '사과'라는 단어나 강아지 사진을 인간처럼 이해하지 못한다. 컴퓨터는 오직 숫자 계산만 잘 한다.
따라서 텍스트, 이미지, 음성 같은 비정형 데이터(Unstructured Data)를 컴퓨터가 이해하고 계산할 수 있는 숫자들의 배열, 즉 벡터로 변환하는 과정이 필요하다.
이 과정이 벡터 임베딩이다.
- 핵심: 단순히 단어를 숫자로 바꾸는 것을 넘어, 단어가 가진 '의미'와 '맥락'을 다차원의 벡터 공간에 좌표로 표시
Word2vec
단어의 의미를 파악해서 벡터로 바꾸는 방법 중 하나
Word2vec의 핵심 철학은 아래와 같다.
"비슷한 위치(문맥)에 등장하는 단어는 비슷한 의미를 가질 것이다."
예를 들어, "강아지가 OO를 먹는다" 라는 문장의 OO에는 '물', '밥' 같은 단어가 들어갈 수 있지만, '컴퓨터'가 들어가긴 어색하다. 이처럼 주변 단어를 통해 특정 단어의 의미를 학습하는 것이다.
학습 모델
1. CBOW (Continuous Bag-of-Words)
- 방식: 주변 단어들을 가지고 중심 단어를 예측하는 모델
- 예시:
["나는", "오늘", "아침으로", "OOO", "먹었다"]라는 문장에서,["나는", "오늘", "아침으로", "먹었다"]를 보고OOO이 '빵'일 것이라고 예측하면서 학습 - 특징: 계산 속도가 빠르고, 작은 데이터셋에서도 잘 작동
2. Skip-gram
- 방식: 위와 반대로 중심 단어를 가지고 주변 단어들을 예측하는 모델
- 예시:
["나는", "오늘", "아침으로", "빵을", "먹었다"]라는 문장에서, '빵'이라는 중심 단어를 보고["나는", "오늘", "아침으로", "먹었다"]를 예측하도록 학습 - 특징: CBOW보다 학습은 느리지만, 자주 등장하지 않는 히귀 단어에 대해서도 의미를 더 잘 파악하는 경향이 있어 성능이 더 좋다고 알려짐
JS에서 사용
Node.js 서버 환경에서 미리 모델을 학습시키거나, 이미 학습된 모델을 불러와 사용하는 방식을 택할 수 있다.
word2vec npm 패키지를 활용하면 된다.